IT之家 11 月 5 日消息,按照 10 月 24 日发布时给出的承诺,月之暗面(Moonshot AI)今日在 Hugging Face 平台开放了 Kimi K3.1 Pro 的模型权重。
在 Arena 运营的 Agent Arena 智能体排行榜中,Kimi K3.1 Pro(Max)位列开放权重模型第一、全部参评模型第 13 位,并在工作、编程与聊天三个类别中均居开放模型首位。
Agent Arena 的评测方式与传统的成对盲测不同。它不要求用户对两个回答投票,而是从真实用户的智能体会话中提取信号,包括用户对任务的明确确认、表扬与投诉、纠正指令以及 Shell 命令执行错误等,再通过 Arena 称为“因果追踪”的随机化推断方法估算各模型相对于平均水平的净改进率。
Kimi K3.1 Pro 此次排名基于全球用户超过 1.75 万次真实长周期智能体任务会话,净改进率为 +5.1%,较上一代 K3(Max)的 +0.9% 提升 4.2 个百分点。
分项指标呈现出更具体的改善幅度。衡量 Shell 命令执行可靠性的 Bash Reliability 从 K3 的-4.5%(第 13 名)升至 +7.9%,在开放模型中排名第一;反映用户满意度的 Praise vs Complaint 指标从 +1.3% 升至 +7.7%;衡量模型根据用户反馈调整执行方向的 Steerability 指标达到 +6.5%,同样居开放模型首位。用户明确确认任务完成的 Confirmed Success 为 +3.9%,开放模型第四。
Kimi K3.1 Pro 采用混合专家架构,总参数量 2.8 万亿,单次推理激活约 1040 亿参数,支持约 100 万 Token 上下文窗口。
与 K3 相比,K3.1 Pro 以 K3 为基座进行了大规模联合强化学习后训练,覆盖数百个下游领域,并将部分全注意力层替换为门控稀疏注意力层,以降低长上下文建模的开销。
值得一提的是,开源权重的“可下载”与“可本地运行”之间存在显著距离。2.8 万亿参数以 BF16 精度存储的权重文件约 5.6TB,即使采用 INT4 量化也仍需约 1.4TB,单机消费级显卡基本不具备部署可能。
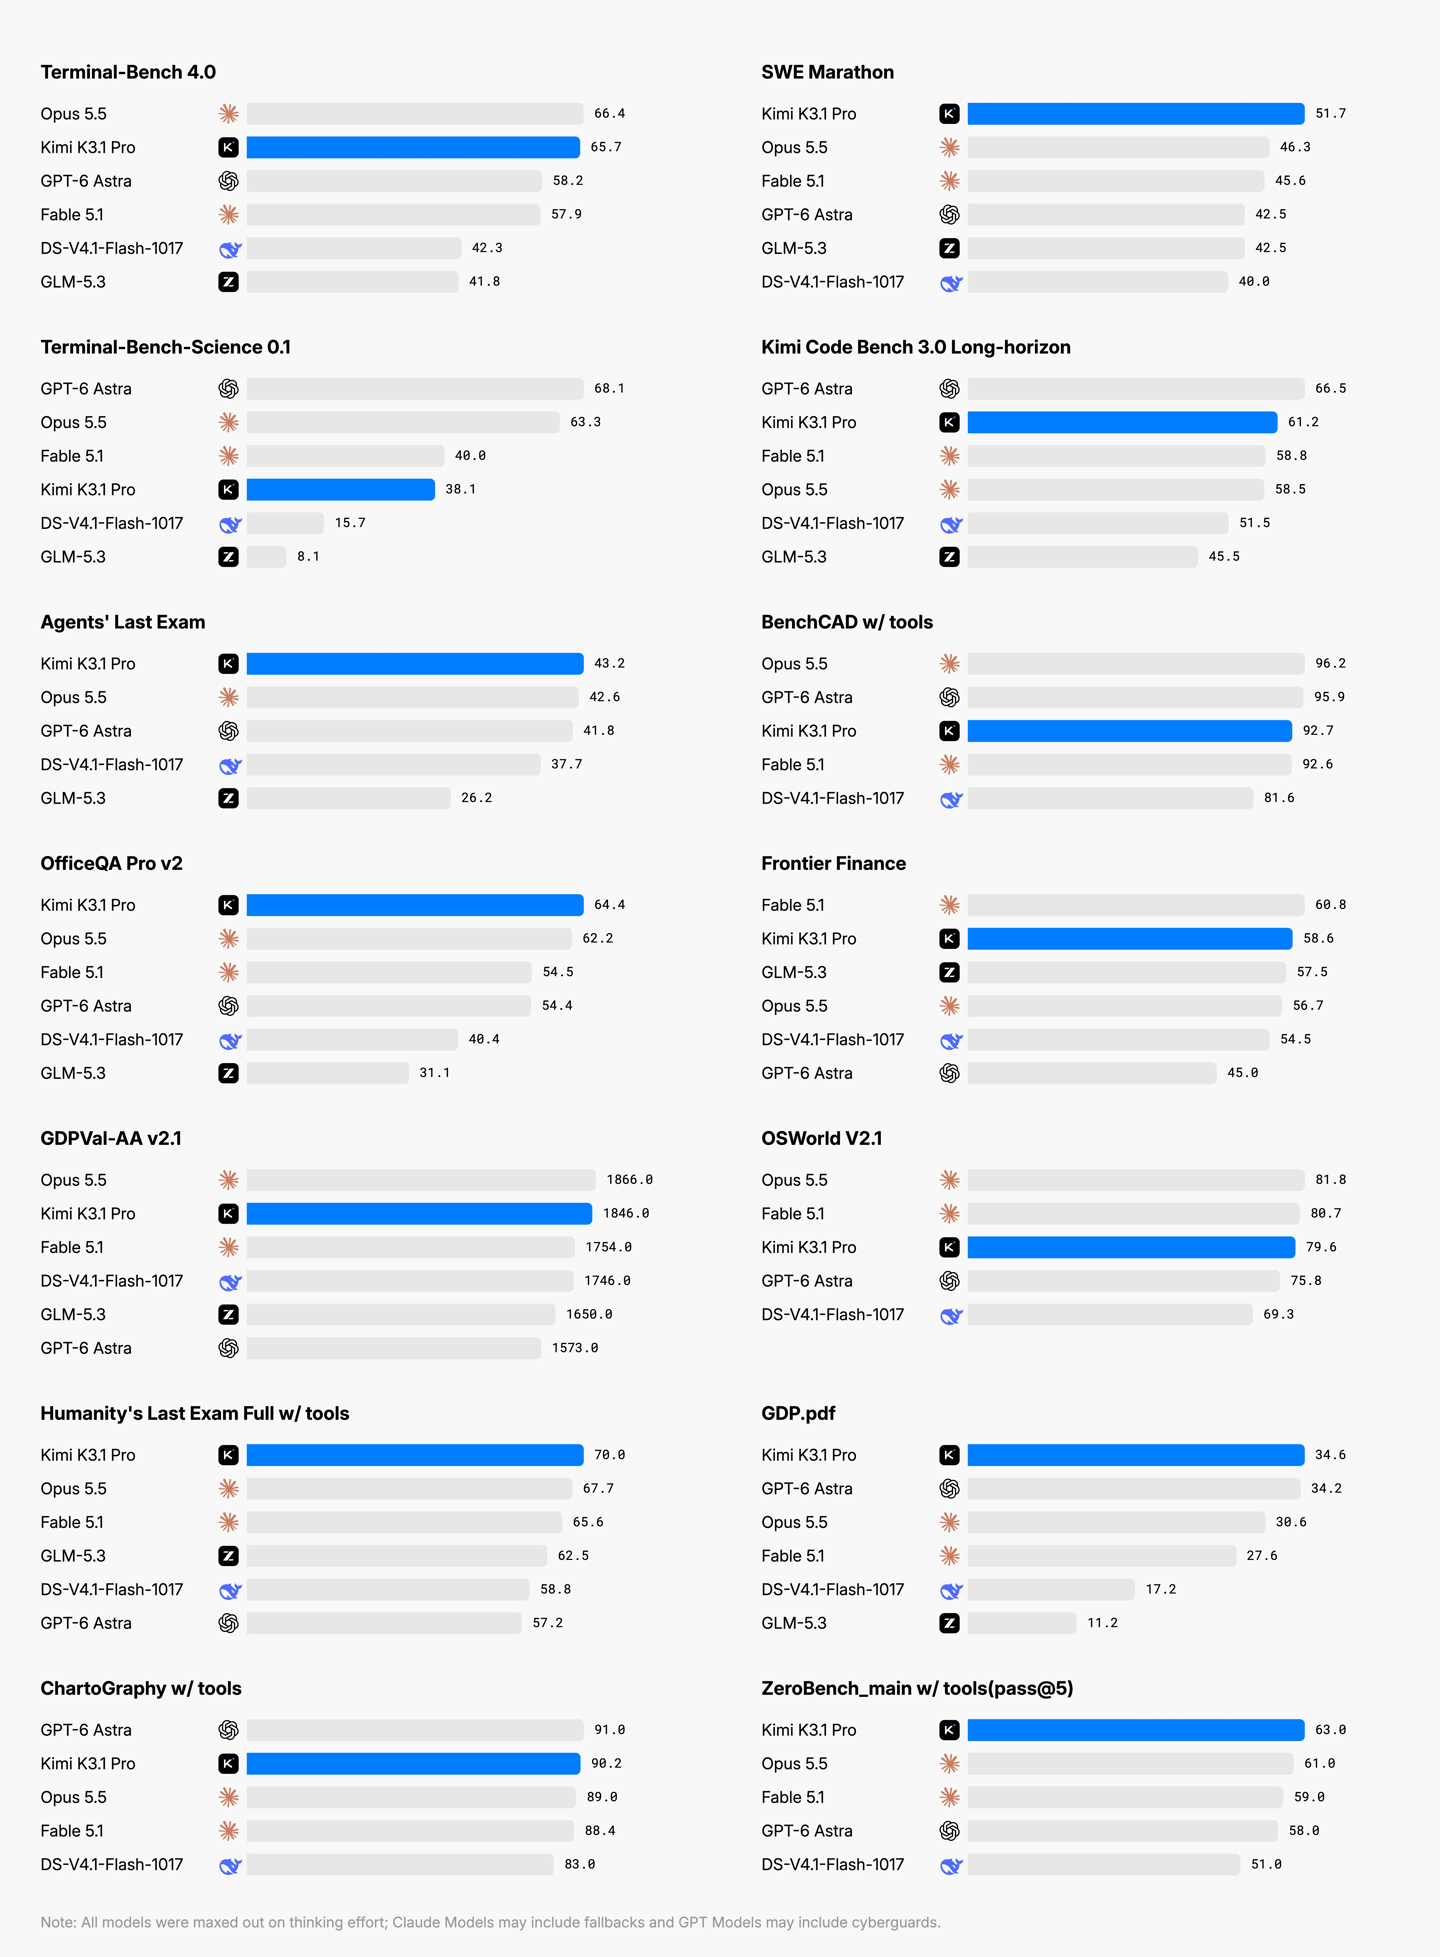
在终端智能体基准 Terminal-Bench 4.0 上,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 相差不到 1 个百分点。
Coding
Terminal-Bench 4.0
65.7
57.9
58.2
66.4
42.3
41.8
Terminal-Bench-Science 0.1
38.1
40.0
68.1
63.3
15.7
8.1
SWE Marathon v1.1
51.7
45.6
42.5
46.3
40.0
42.5
BenchCAD w/o tools
72.8
60.6
73.0
41.2
BenchCAD w/ tools
92.7
92.6
95.9
96.2
81.6
Program Bench
31.5
53.5
50.0
65.0
29.1
19.0
DeepSWE v1.1
75.5
67.4
74.1
74.2
77.0
66.9
PostTrain Bench v1.2
36.5
44.6
41.9
43.8
30.5
34.5
Kimi Code Bench 2.0 (Internal)
77.1
76.1
61.7
Kimi Code Bench 3.0 Long-horizon (Internal)
61.2
58.8
66.5
58.5
51.5
45.5
Agentic
HLE-Full w/ tools
70.0
65.6
57.2
67.7
58.8
62.5
BrowseComp
92.1
91.5
90.8
BioMysteryBench
80.6
81.6
78.9
81.9
80.0
79.6
CharXiv (RQ) w/ python
93.4
92.7
92.8
93.8
85.6
MMMU-Pro w/ python
90.0
88.4
87.8
89.8
82.5
GDP.pdf w/ python
85.7
83.8
85.5
83.9
73.0
ChartoGraphy w/ python
90.2
88.4
91.0
89.0
83.0
BabyVision w/ python
95.4
95.1
96.6
97.7
92.5
ZeroBench_main w/ python (pass@5)
63.0
59.0
58.0
61.0
51.0
Agents' Last Exam (ALL)
43.2
41.8
42.6
37.7
26.2
Agents' Last Exam (CLI)
44.2
40.7
36.0
29.4
Automation Bench-AA
73.3
59.4
68.5
69.5
66.6
62.2
GDPval-AA v2.1 (Elo-score)
1846
1754
1573
1866
1746
1650
AA-Briefcase v1.1 (Elo-score)
1678
1672
1569
1803
1570
1507
APEX-Agents
69.4
68.6
64.7
73.5
69.8
56.6
OfficeQA Pro v2
64.4
54.5
54.4
62.2
40.4
31.1
OfficeQA Pro
67.4
68.6
66.2
62.4
58.6
Frontier Finance
58.6
60.8
45.0
56.7
54.5
57.5
Harvey Legal Agent
23.7
19.1
21.0
HANDBOOK.md
44.6
38.8
41.5
28.9
20.8
OSWorld V2.1
79.6
80.7
75.8
81.8
69.3
Business Operation (Internal)
37.8
30.7
32.3
8.9
18.6
DECK-Arena (Internal, Elo-score)
1456
1423
1253
1231
1119
Design Bench (Internal, Elo-score)
957
1076
927
863
718
Kimi Hallu Bench Hard w/ tools (Internal, lower is better)
8.3
23.3
5.5
15.0
23.3
22.6
Reasoning & Knowledge & Multimodal
GDP.pdf
34.6
27.6
34.2
30.6
17.2
11.2
HLE-Full
51.1
57.6
53.6
59.8
42.6
43.0*
HLE-Diamond
39.4
55.1
65.8
60.9
21.6
25.1*
GPQA-Diamond
94.2
93.7
96.1
93.9
92.2
91.7
CharXiv (RQ)
89.0
88.8
90.0
92.1
77.0
MMMU-Pro
84.1
86.3
86.9
87.7
80.6
ZeroBench_main (avg@5 / pass@5)
29.8 / 39.0
23.0 / 35.0
43.2 / 52.0
35.0 / 43.0
11.8 / 23.0
PerceptionBench
68.3
63.0
77.6
72.1
47.7
Kimi Hallu Bench w/o tools (Internal, lower is better)
5.4
11.4
4.2
6.8
13.1
14.8
Cyber Security
ExploitBench
74.7
83.0
100
91.0
54.4
ExploitGym
20.7
30.4
42.4
34.5
15.0
xdev-bench-hard (Internal)
81.0
85.7
57.1
相关阅读:
《Kimi K3.1 Pro 正式发布:月之暗面最强 3 万亿级模型,编程智能体测评超 GPT-6》
《Kimi 就会员使用 K3.1 Pro 出现限流等问题致歉,为所有订阅会员进行重置》